
Die Zeitersparnis durch Figma Make messen
Das Data-Science-Team von Figma ging davon aus, dass Benutzer*innen durch KI Zeit sparen, für den Nachweis benötigten sie einen neuen Forschungsdesign-Ansatz.
Die Zeitersparnis durch Figma Make messen teilen
Illustrationen von Pete Gamlen
KI-Tools wie Figma Make verkürzen Designzyklen, indem sie repetitive, mechanische Aufgaben übernehmen. Damit entfallen Schritte, die Teams ausbremsen, sodass sie sich auf die wichtigsten Aufgaben konzentrieren können. Viele Teams wissen jedoch nicht, wie viel Zeit sie tatsächlich sparen oder wo sie die größten Effizienzgewinne erzielen. Das Data-Science-Team von Figma versuchte, darauf eine Antwort zu finden, stellte jedoch fest, dass gängige Forschungsansätze wie A/B-Tests und kausale Inferenz die Komplexitäten von KI nicht vollständig berücksichtigen konnten.
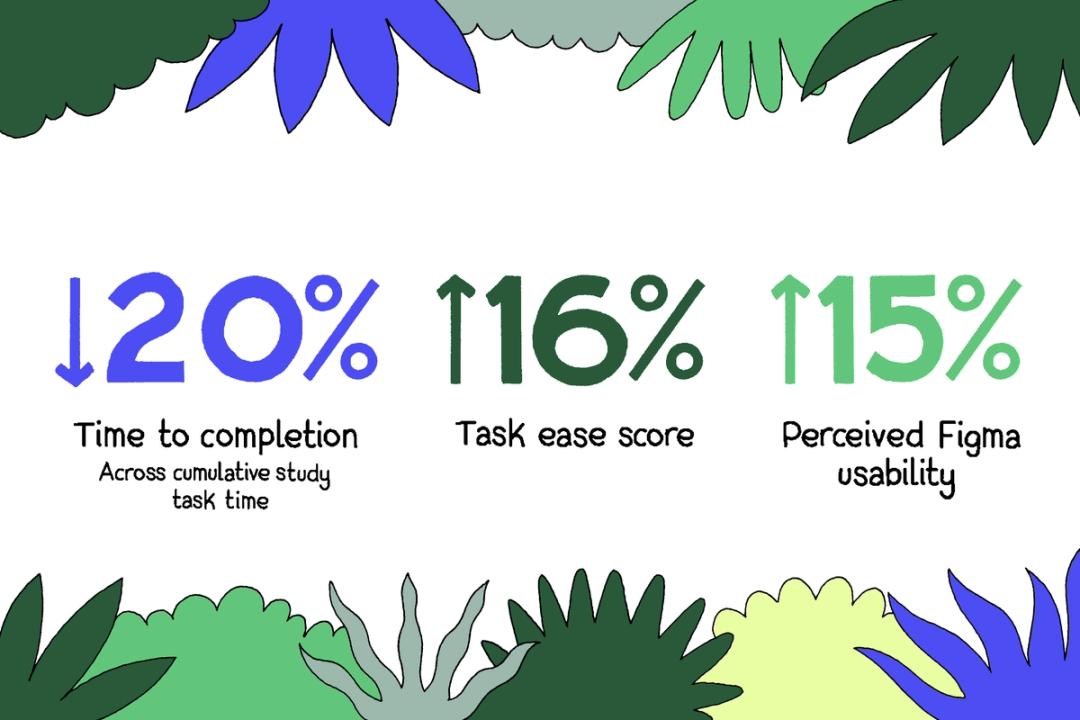
Insgesamt wurden Designarbeiten mit Figma Make 20 % schneller und 16 % einfacher. PMs sahen den größten Nutzen: Aufgaben waren 23 % schneller und 37 % einfacher.
Also entwarfen wir eine randomisierte kontrollierte Studie, bei der wir 100 Teilnehmer*innen baten, Aufgaben mit und ohne Figma Make zu bearbeiten. Hier erhältst du weitere Details dazu, wie wir die Studie entworfen und welche Erkenntnisse wir gewonnen haben.
Kontrolle über die Einflussfaktoren
Das Messen der Zeitersparnis durch die Nutzung von KI ist schwierig, da es zahlreiche Einflussfaktoren gibt, die den Zeitaufwand für eine Aufgabe ebenfalls beeinflussen. Beispiele hierfür sind die Dauer der Betriebszugehörigkeit, Berufserfahrung und die Komplexität der Aufgabe. Jeder dieser Faktoren kann unabhängig von der KI-Nutzung das Arbeitstempo beeinflussen. Die meisten gängigen statistischen Methoden können solche Einflussfaktoren nicht berücksichtigen. Doch ohne Kontrolle über diese Faktoren können wir nicht sagen, wie stark eine Produktivitätsänderung wirklich auf die KI zurückzuführen ist und inwiefern andere Faktoren eine Rolle spielen.
Herausforderungen bei gängigen Methoden
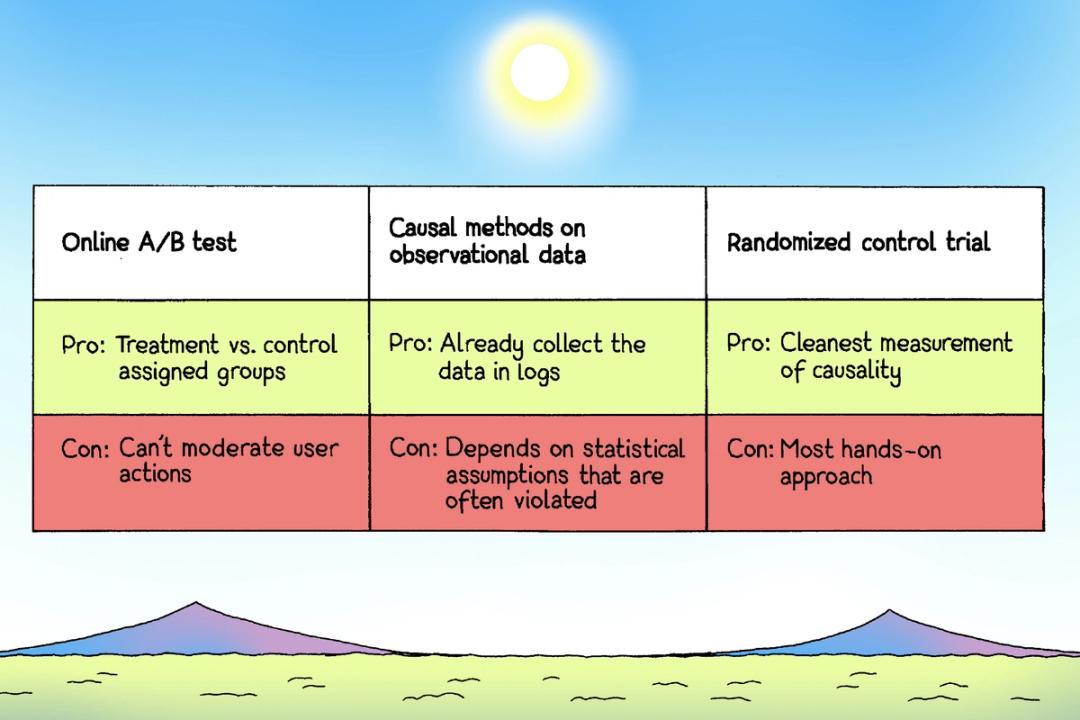
In Bezug auf Einflussfaktoren haben die zwei gängigen Data-Science-Methoden – Online-A/B-Tests und kausale Inferenzen anhand von Daten-Logs – ihre Grenzen.
Wenn zum Beispiel einer Testgruppe Figma Make zur Verfügung gestellt und für eine andere Gruppe deaktiviert wird, dann würden wir messen, wie lange Gruppe A für die Durchführung von Designaufgaben benötigt, und diesen Wert mit Gruppe B vergleichen. Doch auch wenn dies theoretisch zufällig für Einflussfaktoren randomisiert wird, bleibt das Hauptproblem, dass wir die von einzelnen Benutzer*innen durchgeführten spezifischen Aufgaben nicht kontrollieren können. Dadurch lässt sich nicht sicherstellen, dass sie gleich komplex sind.
Kausale Inferenz bestimmt mithilfe statistischer Methoden, ob eine Variable tatsächlich eine Änderung bei einer anderen Variable verursacht, anstatt lediglich Korrelationen herzustellen.
Stelle dir alternativ vor, wir würden Log-Daten analysieren und uns ansehen, wie viel Zeit Benutzer*innen im Durchschnitt mit Designaufgaben verbringen, wenn sie KI-Funktionen nutzen bzw. wenn sie diese nicht nutzen. Es gibt mehrere Methoden kausaler Inferenz, mit denen wir bestimmen können, wie stark die Nutzung von KI das Ergebnis beeinflusst hat, während wir dabei Einflussfaktoren kontrollieren. Allerdings funktioniert keine dieser Methoden wirklich für unsere Zwecke.
Mit Propensity Score Matching(PSM) werden kausale Effekte auf Basis von Beobachtungsdaten geschätzt. Für jeden Datenpunkt (in unserem Fall, jede Designaufgabe in den Logs) schätzen wir den „Propensity Score“, d. h. die Wahrscheinlichkeit, dass er – basierend auf seinen beobachteten Eigenschaften – zur Behandlungserfahrung (in unserem Fall, KI-Nutzung) gehört. Dazu müssen jedoch alle Einflussfaktoren in den Log-Daten enthalten sein. Dies ist bei uns nicht der Fall, da zum Beispiel anonymisierte Benutzer-IDs keine Hinweise auf die subjektive Designerfahrung einer Person geben können.
Instrumentvariablen (IV) sind eine Methode zur Schätzung kausaler Effekte, wenn ein Einflussfaktor nicht direkt gemessen oder kontrolliert werden kann. Um diese Methode zu verwenden, müssten wir in den Daten eine neue Variable (ein „Instrument“) finden, das beeinflusst, ob jemand KI nutzt. Dieses Instrument darf die Geschwindigkeit der Aufgabenbearbeitung auf keine andere Weise beeinflussen und darf nicht mit anderen Einflussfaktoren zusammenhängen. Wenn beide Bedingungen erfüllt sind, können wir das Instrument verwenden, um einen Bereich der KI-/Nicht-KI-Nutzung zu isolieren, der in Bezug auf die Einflussfaktoren im Wesentlichen zufällig ist. Das Problem ist, dass es für uns kein gültiges Instrument gibt: Nichts in den Log-Daten beeinflusst jemanden dahingehend, KI-Funktionen aus Gründen zu nutzen, die nicht mit der Designerfahrung oder Aufgabe zu tun haben.

Die Entscheidung für einen randomisierten Kontrollversuch
Randomisierte Kontrollversuche (RCTs) sind der Goldstandard zur Messung des gültigen kausalen Einflusses und die Herangehensweise, auf die wir uns für diese Studie geeinigt haben. Mit RCTs verfügen wir zu Beginn der Datenerhebung über vollständige Kontrolle über die Einflussfaktoren, indem wir die zufällige Zuweisung, das standardisierte Aufgabenformat und die Studienmoderation kombinieren:
- Die Randomisierung der Teilnehmer*innen zwischen Behandlungs- und Kontrollgruppe stellt sicher, dass Einflussfaktoren ungefähr gleichmäßig auf die beiden Gruppen verteilt sind.
- Wenn die Teilnehmer*innen dieselben Aufgaben erhalten, wird der Einfluss unterschiedlicher Aufgabenattribute auf unsere Zielvariable „Bearbeitungsdauer“ eliminiert.
- Die Moderation durch ein geschultes Forschungsteam reduziert die Variabilität der durchgeführten Arbeit nach der Gruppenzuweisung zusätzlich und schützt vor anderen potenziellen Verletzungen statistischer Voraussetzungen.
Wir haben mit Benutzungsforscher*innen bei und außerhalb von Figma zusammengearbeitet, um einen RCT zu entwickeln und durchzuführen, mit dem wir feststellen können, wie viel Zeit Produktdesigner*innen und Produktmanager*innen bei der täglichen Designarbeit durch den Einsatz von Figma Make sparen.
Wir haben Make gewählt, weil dieses Produkt bei Figma-Benutzer*innen sehr beliebt ist und für viele Aufgaben eingesetzt werden kann. Je mehr KI-Tools den Studienteilnehmer*innen zur Verfügung stehen, desto mehr Variablen wären in Bezug auf mögliche Zeitersparnisse erforderlich gewesen, daher wollten wir die Studie auf ein einziges Tool beschränken.
Um zu bestimmen, wie viele Teilnehmer*innen in die Studie einbezogen werden sollten, verwendeten wir Effektgrößen, die in gleichartigen Studien in der Branche beobachtet wurden, z. B. die GitHub-Copilot-RCTs. Dann verwendeten wir diese approximierte Effektgröße, um eine Power-Analyse durchzuführen, die uns zu unserer endgültigen Stichprobengröße von 100 Teilnehmer*innen führte, bestehend aus 50 Produktdesigner*innen und 50 Produktmanager*innen. Power-Analysen bestimmen die Stichprobengrößen, die erforderlich sind, um statistisch signifikante Effekte innerhalb der Studie zu erkennen.
Wir wussten, dass wir bei Produktdesigner*innen – unseren Power-Usern von Make – Zeitersparnisse messen würden, aber wir waren auch neugierig, ob Produktmanager*innen (PMs) Zeitersparnisse erzielen. Wir wussten bereits aus der Benutzerforschung, dass Make für PMs die Tür zum Design geöffnet hat, und wir wollten ihr Erlebnis besser verstehen.
Gestaltung des Versuchs
Bei dem Versuch ging es im Kern darum, dass die Behandlungs- und Kontrollgruppen die gleichen Designaufgaben bewältigen sollen, wobei der einzige Unterschied zwischen den Gruppen darin besteht, dass die Behandlungsgruppe Zugang zu Make hat, während die Kontrollgruppe kein KI-Tool nutzen kann.
Bei der Gestaltung der Aufgaben für die Teilnehmer*innen war unsere erste Überlegung die Vertrautheit. Unsere Aufgaben mussten von allen Teilnehmer*innen verstanden werden, unabhängig von ihrer tatsächlichen Designerfahrung. Wir entschieden uns für die Bearbeitung von Social-Media-Posts.
Wir wollten in der Studie eine Reihe von gängigen Design-Workflows testen, um mehrere Signale für den Einfluss von Make auf eine Vielzahl von Designaufgaben und so ein robusteres kumulatives Ergebnis zu Zeiteinsparungen zu erhalten. Als zentrale Design-Workflows für den Test identifizierten wir die Themen Änderungen in der UI und im Erscheinungsbild, das Erstellen neuer Ansichten in einem Basisdesign und das Hinzufügen von Interaktivität und Reaktionsfähigkeit. Dazu erstellten wir insgesamt drei Szenarien.

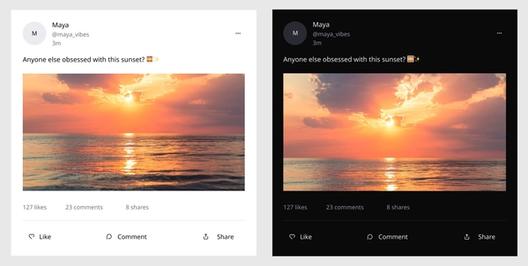

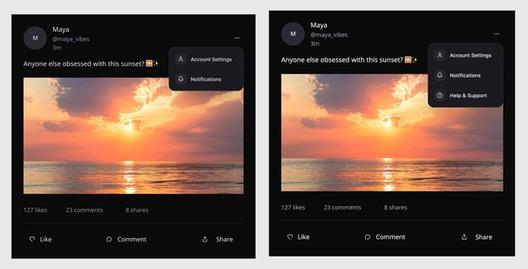

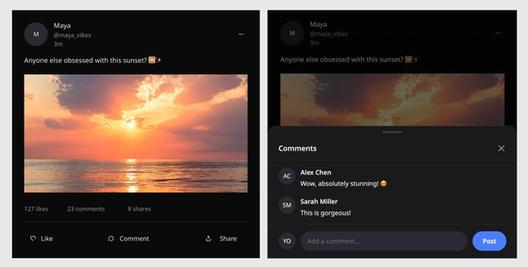
Bei der Gestaltung der Studienaufgaben bestand die größte Herausforderung darin, dass sie für Produktdesigner*innen nicht zu einfach und für Produktmanager*innen nicht zu schwer sein durften. Wir haben interne Pilotversuche mit Figma-Designer*innen und Produktmanager*innen durchgeführt, um unsere Aufgaben mit realen Teilnehmer*innen zu testen. Dabei haben wir festgestellt, was in unseren Szenarien funktionierte und was nicht, und wir haben die Aufgaben selbst dreimal neu gestaltet, bevor wir ihre endgültigen Versionen fanden.
Moderation der Studie
Unsere nächste Herausforderung: Wir mussten ein Team von Moderator*innen dazu schulen, wie sie die Studie für 100 Teilnehmer*innen durchführen können. Da Unterschiede in der Moderation zu einem weiteren Einflussfaktor werden könnten, entwickelten wir ein Skript, mit dem alle Moderator*innen die Teilnehmer*innen nach dem gleichen Standard durch den Studien-Workflow führen sollten.
Unsere Moderator*innen hatten zudem alle unterschiedliche Niveaus an Figma-Kenntnissen, sodass das Maß an Anleitung, das sie Teilnehmer*innen während der Studie bieten konnten, variierte. Daher haben wir einen Leitfaden zur Problembehebung geschrieben, den Moderator*innen als Referenz für die Unterstützung der Teilnehmer*innen nutzen konnten. Bei neu auftretenden Problemen wurde dieser Leitfaden im Laufe der Studie überarbeitet.
Die Ergebnisse
Die Identifizierung unserer Teilnehmer*innen, die Gestaltung des Versuchs und die Vorbereitung auf die Moderation brachten Komplexitäten ans Licht, für deren Behebung mehrere Iterationen vom Team erforderlich waren. Trotz dieser Herausforderungen schlossen alle 100 Teilnehmer*innen die Studie erfolgreich ab. Wir sind zu diesen wesentlichen Ergebnissen gelangt:
- Insgesamt sahen die Teilnehmer*innen eine Reduzierung des kumulativen Zeitaufwands für die Erledigung der Aufgaben um 20 %, eine Verbesserung bei der Einfachheit der Aufgaben um 16 % und eine Verbesserung der wahrgenommenen Figma-Benutzerfreundlichkeit um 15 %.
- Produktmanager*innen berichteten in allen getesteten Dimensionen durchweg über größere Fortschritte als Produktdesigner*innen. Der Zeitgewinn für PMs mit Zugang zu Make betrug laut unserem Interaktionsregressionsmodell kumuliert für alle Studienaufgaben 23 %. In der Gesamtsumme des Versuchs waren Produktmanager*innen, die Make verwendeten, fast so effizient wie Produktdesigner*innen ohne Make.
- Das abschließende wichtige Ergebnis betrifft die Art der Designaufgaben, bei denen Produktdesigner*innen im Vergleich zu PMs Zeit sparten. PMs berichteten von Fortschritten bei den beiden einfachsten und schnellsten Aufgaben unserer Studie, verzeichneten aber keine statistisch signifikanten Verbesserungen bei der anspruchsvollsten und umfangreichsten Aufgabe in der Studie. Bei Produktdesigner*innen gilt das Gegenteil: Sie berichten nur bei der anspruchsvollsten Aufgabe von statistisch signifikanten Verbesserungen der Aufgabenzeit, nicht jedoch bei den beiden einfacheren Szenarien. Mit anderen Worten: Make fördert schnellere Entwicklung von Grund auf sowie komplexes Interaktionsdesign für Designer*innen, während es für PMs eher als Basistool für schnelle Designbeiträge dient.

Wir verwendeten eine Kombination aus Hypothesentests und OLS-Regressionsmodellierung, um unsere Ergebnisse zu analysieren. Alle hier beschriebenen Ergebnisse sind statistisch signifikant, sofern nicht anders angegeben.
Aufgrund unseres Studiendesigns können wir mit Sicherheit sagen, dass Make diese Verbesserungen verursacht. Dieser Ansatz war robust gegenüber Einflussfaktoren und anderen Formen von Verzerrungen, und wir planen, weitere wichtige Produktfragen mithilfe von RCTs zu beantworten.
Wir bereiten bereits weitere Forschungsprojekte vor, die auf dieser anfänglichen Arbeit aufbauen werden. Wir werden einen ähnlichen RCT für den neuen Figma Design-Agenten durchführen, wobei wir uns besonders dafür interessieren, wie parallele Agentenfähigkeiten die Zeitersparnis weiter verstärken können. Wir beabsichtigen auch, neue Hypothesen zu untersuchen, die sich auf die Auswirkungen von KI auf die Designqualität, die Vereinfachung von Multiplayer-Zusammenarbeit und weitere Bereiche konzentrieren.

Lade die vollständige Studie herunter, um mehr über Zeitersparnis mit Figma Make zu erfahren.

