Comment nous sécurisons les systèmes internes de Figma avec des agents
Notre équipe de sécurité a développé un agent IA qui trie les alertes, mène des investigations, effectue des requêtes sur notre lac de données de sécurité, écrit du code pour résoudre les problèmes et apprend au fil de son fonctionnement. Voici comment nous avons réduit le temps de résolution des alertes de 71 % et transformé le travail de nos ingénieurs chargés de les traiter.
Partager Comment nous sécurisons les systèmes internes de Figma avec des agents
Illustrations de Jimmy Simpson
Les menaces contre lesquelles nous protégeons nos plateformes internes dans l'équipe d'ingénierie sécurité de Figma évoluent constamment. L'infrastructure cloud change fréquemment, les développeurs adoptent de nouveaux outils, et ce que les collaborateurs installent et utilisent sur leurs ordinateurs portables varie d'un trimestre à l'autre (par exemple lorsque l'équipe Designer Advocates commence à coder ses propres applications et automatisations).
Notre système de gestion des informations et des événements de sécurité (SIEM), Panther, nous aide à anticiper toutes ces menaces en réalisant un grand nombre de vérifications sur nos infrastructure cloud, points d'extrémité, applications SaaS et systèmes d'identité. Lorsqu'il détecte un problème potentiel, il envoie des alertes dans Slack et crée un ticket Asana pour que les ingénieurs dédiés puissent s'en occuper. Historiquement, la résolution des problèmes passait par une énorme quantité de tâches manuelles. Le principal défi était d'identifier précisément le contexte. Il fallait déterminer si l'alerte ressemblait à quelque chose de déjà vu la semaine précédente, s'il y avait une PR en attente qui pourrait résoudre le problème, si des threads Slack mentionnaient un élément associé, et ainsi de suite.
Comme de nombreuses équipes, nous avons vu les capacités des modèles LLM s'accélérer rapidement au cours de l'année écoulée. Nous avons récemment communiqué sur la manière dont Figma garde une longueur d'avance sur le traitement des vulnérabilités avec des agents dans notre base de code, qui a détecté des problèmes dans les changements de configuration pour des outils sensibles comme Okta et AWS grâce à des investissements antérieurs dans le stockage de la configuration en tant que code. Mais pour réduire significativement les tâches fastidieuses et améliorer la protection des systèmes internes de Figma, nous avons dû aller au-delà de la base de code et construire un nouveau système capable de nous aider à gérer l'étendue des problèmes détectés par notre SIEM.
Nous nous sommes d'abord fixé un objectif limité : construire un couche de récupération capable de mettre en avant le raisonnement des ingénieurs sur des problèmes antérieurs au déclenchement d'une nouvelle alerte. Ce projet a finalement évolué vers un système entièrement agentique qui enquête sur les alertes, interroge les journaux d'audit, écrit des modifications de code, ouvre des PR et s'améliore au fil du temps grâce à sa propre mémoire. La manière dont notre équipe de sécurité travaille a complètement changé.
La couche RAG : la mémoire des alertes
Nous avons commencé par développer un système de classification renforcé par une récupération de données, basé sur les bases de connaissances AWS Bedrock et Amazon Kendra. Encore une fois, notre objectif initial était simplement de faire ressortir le contexte historique de ce qui s’était passé la dernière fois que la même alerte avait été déclenchée, et peut-être de supprimer les alertes en double.
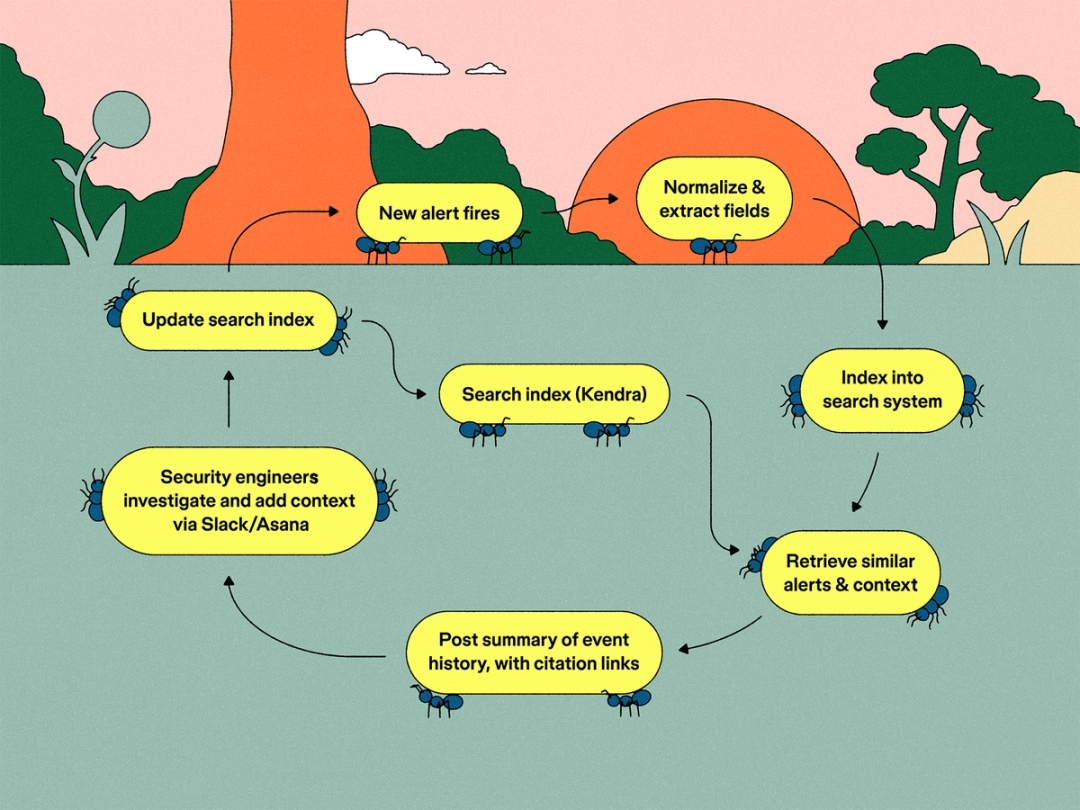
Lorsqu'une alerte Panther se déclenche, notre gestionnaire Lambda la convertit en un document standardisé et l'indexe dans Kendra. Nous extrayons des champs structurés de la charge utile de l'alerte brute : IP de p_any_ip_addresses, acteurs de p_any_usernames et divers champs utilisateur spécifiques au fournisseur, ID de compte AWS des ARN. Ceux-ci deviennent des attributs de document Kendra recherchables aux côtés du titre de l'alerte, de la gravité, des balises et des horodatages :
const attrs: DocumentAttribute[] = [
  { Key: 'alert_id', Value: { StringValue: doc.alert_id } },
  { Key: 'alert_type', Value: { StringValue: doc.alert_type } },
  { Key: 'severity', Value: { StringValue: doc.severity } },
  { Key: 'status', Value: { StringValue: doc.status } },
  { Key: 'created_at', Value: { DateValue: doc.created_at } },
  { Key: 'has_investigation_context', Value: { LongValue: doc.has_investigation_context } },
]
Lorsqu'une alerte similaire se déclenche à nouveau, nous interrogeons Bedrock pour trouver des correspondances sémantiques en utilisant le titre de l'alerte (qui est généralement le nom de la détection suivi du nom d'utilisateur de l'acteur) comme vecteur principal :
function buildQueryFromAlert(alert: Alert): string {
  return `${alert.data.title}\n\nhas_investigation_context=1`
}
Autre axe pour améliorer les recommandations : privilégier les résultats récents. Une alerte similaire datant de deux jours est bien plus utile qu'une alerte identique datant de six mois, car notre manière de trier les alertes évolue aussi sans cesse.
Nous privilégions la récupération des alertes avec investigation_context, qui sont des commentaires laissés sur Slack par les ingénieurs qui les ont traités. (Une alerte fermée sans commentaires ne donne quasiment aucune information.) Nous capturons le contexte des investigations sans changer les flux de travail existants de nos ingénieurs. Quand quelqu'un laisse une note dans un fil d'alerte Slack (et nous avons une procédure similaire pour les tickets Asana), nous indexons ce commentaire dans Kendra comme contexte d'enquête sur l'alerte originale :
export async function addInvestigationContext(
  alertId: string, contextText: string
): Promise<void> {
  const existingDoc = await findAlertDocument(alertId)
  if (!existingDoc) return

  let updatedContext: string[]
  updatedContext = [...existingDoc.investigation_context, contextText]

  const updatedDoc: AlertDocument = {
    ...existingDoc,
    investigation_context: updatedContext,
    has_investigation_context: 1,
  }
  await reindexDocument(updatedDoc)
}
Chaque fois que quelqu'un écrit un commentaire utile sur un fil d'alerte, il simplifie la classification de toutes les alertes similaires dans le futur. Nous n'avons pas eu besoin d'un outil d'annotation spécial ou d'un pipeline de formation, car le workflow existant est le pipeline d'entraînement.

Rôle et limites de la récupération d'informations
Notre système de récupération génère et poste un résumé (pour lecture par un humain) dans Slack/Asana pour chaque alerte. Ce fonctionnement a immédiatement allégé le travail de nos équipes chargées de traiter les alertes. Confirmation de notre objectif, le temps de classification des alertes s'en est trouvé réduit, mais cela nous a également poussés à des modifications programmatiques pour éviter la multiplication épuisante des alertes. Si une alerte est identifiée avec un haut degré de certitude comme étant bénigne ou correspondant en réalité à un doublon, nous abaissons automatiquement son niveau de gravité :
if (autoResolutionConfidence >= 7) {
  if (updatedSeverity === 'high' || updatedSeverity === 'critical') {
    await alertsDb.updateAlertSeverity(alert.alertId, 'medium')
  }
}
Nous avons constaté une diminution de 20 % des pages relatives aux alertes suite à ce changement seul.
Une fois notre système RAG en place, nous avons commencé à réfléchir à l'étape suivante, qui semblait évidente : une sorte de couche agentique pour aider à l'investigation des alertes et résoudre les problèmes automatiquement.
Ajout d'une couche agentique
Nous utilisons Tines pour l'automatisation des workflow et tirons parti de sa capacité à exécuter des boucles d'agents LLM avec des interfaces d'outils explicites : lire un fil Slack, rechercher un utilisateur Okta, effectuer une requête sur les données Panther, ouvrir une PR dans un dépôt spécifique, etc. Un ingénieur peut consulter la liste des outils et réfléchir à ce que l'agent peut et ne peut pas faire. Lorsque vous donnez à un système automatisé l'accès aux données de sécurité de production, cette auditabilité est d'une grande valeur.
Nous avons utilisé Tines pour créer une couche agentique pour compléter notre RAG. Lorsque Panther détecte un événement, notre gestionnaire de flux Lambda publie l'alerte sur Slack avec le résumé LLM de premier passage et les références d'alertes similaires de la couche RAG, puis il ajoute automatiquement le tag @Tines sécurité Slackbot dans le fil. Les équipes techniques peuvent aussi taguer manuellement le bot dans n'importe quel fil pour l'invoquer à la demande afin de poser des questions de relance ou d'obtenir d'autres informations spécifiques selon les besoins.
Lorsque le bot est tagué, un webhook est déclenché dans Tines et la première action qui s'exécute est le routage d'intention. Un modèle plus léger (comme Claude Sonnet) lit le fil complet de Slack et classe la demande : s'agit-il de la classification d'une alerte, d'une question de sécurité de la plateforme, d'une demande d'approbation d'application, ou autre chose ? Chaque catégorie pointe vers un agent spécialisé avec son propre inventaire d'outils, une couche d'autorisation et un prompt de systèmes. L'agent de tri des alertes traite la majeure partie des tâches, mais le fait d'avoir des agents séparés pour différentes intentions nous permet de disposer d'un ensemble d'outils spécialisés sans le recours risqué à un un agent tentaculaire qui a accès à tout.

Boîte à outils de l'agent de tri des alertes
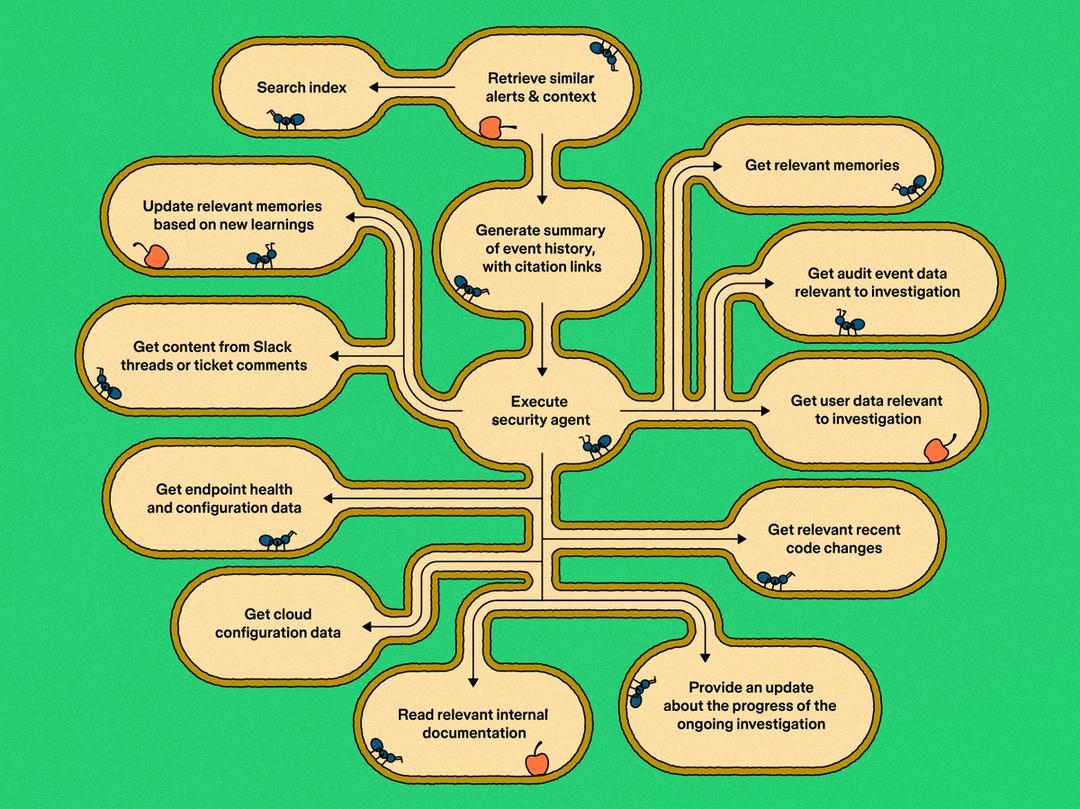
L'agent de tri des alertes (utilisant un modèle comme Claude Opus) centralise une grande partie des investigations. Il reçoit tout l'historique du fil Slack comme contexte, il dispose de sa propre mémoire de guidage (nous y reviendrons plus tard) et d'un ensemble d'outils typiquement utilisés par un humain en charge de classifier les alertes, notamment :
- Okta : obtention du profil d’un utilisateur, liste de ses groupes, vérification de l’historique de connexion, recherche des utilisateurs à l'aide de filtres. Lorsqu’une alerte signale une activité suspecte en provenance d'un acteur spécifique, la première chose que l'agent fait généralement est de récupérer son profil Okta pour comprendre qui il est et à quoi il est supposé avoir accès.
- North Pole Security Workshop (qui gère notre outil de sécurité des points d'extrémité, Santa) : recherche de règles, recherche d'événements, vérification du statut de synchronisation de l'hôte, push des règles vers les hôtes. Si l'alerte concerne un exécutable bloqué ou une violation des règles aux points d'extrémité, l'agent peut consulter l'ID de signature, vérifier l'historique des événements pour cet exécutable et voir si d'autres utilisateurs rencontrent le même blocage.
- Wiz : extraction des journaux d'audit, inventaire des ressources cloud, conclusions des recherches de vulnérabilités, problèmes ouverts et ressources exposées. Pour les alertes relatives à l'infrastructure cloud, l'agent peut vérifier si une ressource signalée présente des vulnérabilités ou des erreurs de configuration connues.
- Slack : lecture des réponses dans les discussions, recherche de profils utilisateur, envoi d'informations mises à jour sur les avancées. L'agent lit les discussions antérieures qui sont liées à des alertes similaires pour intégrer le raisonnement des intervenants et la discussion associée.
- Panther : obtention d'informations sur l'alerte, récupération des événements bruts qui ont déclenché une alerte, énumération des alertes associées. Cela donne à l'agent accès à la charge utile structurée de l'alerte au-delà de ce qui a été publié sur Slack.
- Modification de code : ouverture de PR dans notre dépôt de détections Panther ou notre monorepo. Plus d'informations à suivre sur ce sujet.
- Sous-agent d'investigation Panther : agent séparé alimenté par LLM qui peut écrire et exécuter du SQL Snowflake sur notre lac de données de sécurité complet. C'est l'outil le plus puissant de l'ensemble, et nous en reparlerons.
Interrogation du lac de données de sécurité
L'agent de tri peut répondre à de nombreuses questions avec ses outils directs : « Qui est cet utilisateur dans Okta ? », « Quelles règles Santa s'appliquent à cet exécutable ? », « Cette ressource cloud est-elle dans Wiz ? » Mais de nombreuses enquêtes doivent aller plus loin. Que faisait cet utilisateur sur AWS deux heures avant l'alerte? Quels processus étaient en cours d'exécution aux points d'extrémité et ces processus faisaient-ils quelque chose d'inhabituel ? Ont-ils accédé à d'autres applications ou effectué des modifications de configuration pendant cette période ?
Pour ces questions, l'agent de tri fait appel à un sous-agent d'investigation distinct. Ce sous-agent (également un modèle comme Claude Opus) récupère une requête en langage naturel de l'agent parent et la traduit en SQL Snowflake. Il fonctionne sur notre entrepôt de données Panther, qui ingère des journaux d'audit de toute l'entreprise : AWS CloudTrail, journaux système Okta, événements d'audit GitHub, journaux d'audit GCP, télémétrie des points d'extrémité osquery, événements Workshop/Santa, résultats Wiz, et une centaine d'autres tables environ.
L'agent parent formule sa demande comme vous poseriez une question à un collègue : « Trouve les connexions Okta les plus récentes pour l'utilisateur X au cours des dernières 48 heures » ou « Vérifie quels processus l'utilisateur Y a exécutés sur son terminal au cours des deux derniers jours » ou encore « Que faisait l'utilisateur Z dans AWS EKS entre 10:21 et 20:21 UTC le 10 mars ? » Le sous-agent détermine dans quelles tables rechercher, quelles colonnes utiliser et quels filtres temporels appliquer.
Cette stratégie fonctionne, mais l'organisation des informations dans les tables peut manquer de cohérence globale. Les noms de colonnes ne sont pas cohérents entre les différents journaux sources, les clés de jointure ne sont pas nécessairement bien documentées, et les fonctions de partitionnement temporel peuvent varier selon les tables. Sans aide, le sous-agent passerait par quatre ou cinq requêtes pour analyser l'organisation des données avant de pouvoir répondre à la question posée. Ou pire, lancer une requête qui retournerait des résultats incorrects ou incomplets. Nous verrons comment nous avons résolu ce problème dans la section sur la mémoire ci-dessous.
Développement et segmentation de la mémoire de l'agent
La mémoire s'est avérée être l'élément avec le plus d'impact sur l'utilité du système au fil du temps. Nous en avons plusieurs types, et le fait de les garder séparés s'est révélé très important.
Le corpus RAG est ce que nous appelons la mémoire des cas. C'est le système que nous avons déjà décrit : alertes historiques enrichies du contexte d'enquête de Slack et Asana. Lorsque l'agent doit savoir à quoi ressemblaient des situations similaires, ou trouver les conclusions d'un intervenant sur un incident passé, c'est là qu'il regarde.
En plus de cela, nous avons ce que nous appelons la mémoire de guidage. Cet outil sert à guider le comportement de l'agent ; il est stocké sous forme de document markdown et chargé dans le contexte de l'agent au début de chaque exécution. Voyez-le comme un fichier AGENTS.md ou un modèle des menaces dont un agent scannant la base de code à la recherche de vulnérabilités aurait besoin. Il contient des règles comme « lorsque tu vois des alertes de synchronisation Okta obsolètes, vérifie les jobs ressource-synch et group-sync avant de conclure qu'il s'agit d'un problème systémique » ou « l'utilisateur X effectue des maintenances sur le système Y cette semaine, traite ces alertes comme étant prévues ».
L'agent peut mettre à jour sa propre mémoire de guidage lorsqu'un ingénieur en sécurité la corrige. Si quelqu'un dit « tu as mal géré cela, voici ce que tu aurais dû faire à la place », la correction est conservée pour une potentielle utilisation future. Mais nous avons appris à être prudents quant à ce qui entre dans la mémoire de guidage par rapport à ce qui reste dans la couche RAG. Une leçon ponctuelle sur un type d'alerte spécifique est du ressort du contexte d'enquête et peut servir de précédent pour des alertes similaires à l'avenir. Une règle comportementale qui doit changer la façon dont l'agent aborde toutes les alertes est du ressort de la mémoire de guidage. Nous avons d'abord fait l'erreur de tout enregistrer dans la mémoire de guidage, ce qui a commencé à modifier le comportement de l'agent de manière indésirable. Les précédents et les règles sont des choses différentes et doivent pas se trouver au même endroit.
Nous utilisons également des enregistrements basés sur des bases de données dans Tines pour les objets associés à un état : PR ouvertes créées par l'agent, état d'une investigation Panther, éléments nécessitant des clés stables ou suivi de statut plutôt que récupération en langage naturel. Ces éléments sont plus basiques mais nécessaires.
La couche de mémoire la plus intéressante est la mémoire procédurale, et elle résout directement le problème de la découverte de schéma décrit ci-dessus. Nous avons donné au sous-agent d'investigation sa propre réserve de mémoire, organisée par tags (aws, okta, osquery, workshop, etc.). Avant de commencer une requête, l'agent charge les souvenirs pertinents pour les sources de données qu'il s'apprête à interroger. Après avoir terminé une investigation nécessitant une découverte de schéma, il enregistre ce qu'il a appris :
Title: Job Description Fields in Workiva Logs (2026-03-12T16:25:21 UTC)
Memory: Job descriptions for each user within the system can be found within the field 'jd' in the table 'WORKIVA_USERS'.
Un deuxième LLM (utilisant un modèle plus léger) s'occupe du formatage réel de la mémoire : il prend les constatations brutes, génère un titre avec un horodatage UTC, ajoute des tags et écrit dans la mémoire. La première fois que nous avons interrogé l'agent d'investigation sur des activités dans Zoom, il a eu besoin de multiples requêtes de découverte. Après enregistrement dans la mémoire, la même question ne nécessitait plus qu'une seule requête. Ce schéma s'est répété sur les différentes sources de données, l'agent construisant son propre manuel opérationnel par une succession d'essais et d'erreurs.
Exemples d'investigations par l'agent
Voici trois exemples récents pour illustrer le fonctionnement de l'agent en pratique.
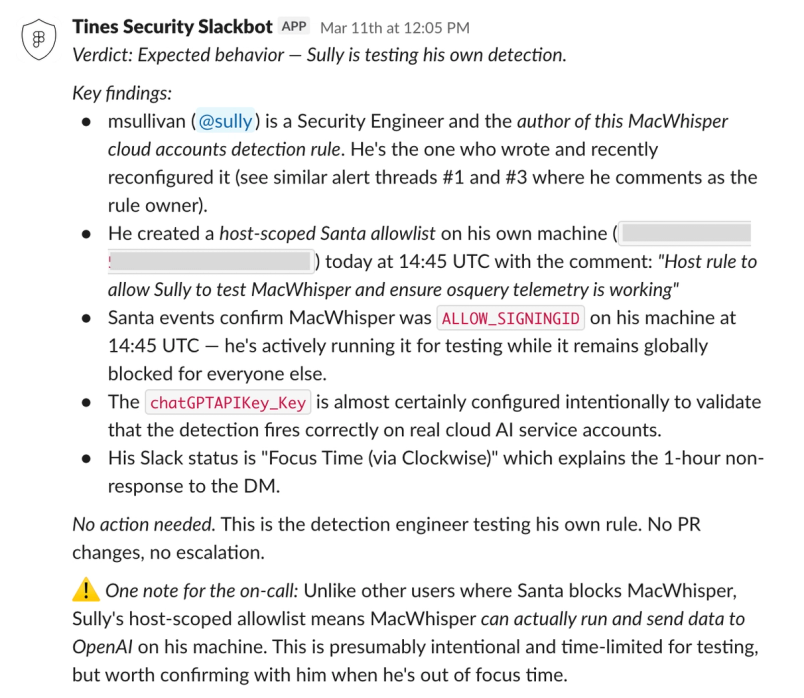
Premier cas : une alerte s'est déclenchée quand quelqu'un a installé une application de transcription audio macOS sans examen ni validation préalable pour une utilisation chez Figma. L'agent de tri a lu le fil d'alerte, extrait des alertes historiques similaires de la couche RAG, puis a utilisé ses outils Okta et Workshop pour assembler toutes les pièces du puzzle : l'acteur concerné était le même ingénieur que le rédacteur de la règle de détection, moi, Matthew ! Workshop a indiqué une règle à portée individuelle, créée le jour même pour des tests. Conclusion : l'auteur de la règle faisait ses propres tests. Aucune action n'était nécessaire. L'agent a même noté que, d'après mon statut Slack, j'étais très concentré, peut-être peu de temps avant de pouvoir confirmer mes activités.

Deuxième : des pages d'alerte Snowflake répétées continuaient à se déclencher pour le même compte de service. L'agent a décrit l'état actuel, déléguant au sous-agent d'investigation les requêtes dans les journaux d'audit pertinents, a identifié pourquoi les alertes étaient récurrentes, a constaté qu'un brouillon de PR avait déjà été ouvert pour les supprimer, et a expliqué que la solution à long terme était déjà en discussion dans un autre fil. L'ingénieur traitant ce cas a obtenu une image complète sans ouvrir un seul onglet, ce qui était encore inimaginable il y a quelques mois.
Enfin, des alertes sont souvent déclenchées pour des situations qui pourraient être liées à des logiciels malveillants, mais qui correspondent en général à des comportements tout à fait légitimes (par exemple, un service de lancement inconnu installé sur des MacBook chez Figma). Dans le passé, cela aurait été impensable ; notre équipe apporte son assistance à des milliers de collaborateurs Figma, et nous serions rapidement submergés par le volume d'alertes. Avec ce nouveau mode de fonctionnement, notre agent peut vérifier que l'exécutable est signé par une entité de confiance, utiliser la capacité de requête Panther pour déterminer comment il a été installé (brew, Store d’applications, etc.), puis rédiger automatiquement les modifications de code nécessaires pour supprimer les futures alertes dans des conditions bien connues et sûres, tout cela sans intervention humaine.
De l'enquête aux modifications de code
L'étape qui nous a le plus surpris, en termes de temps économisé, est lorsque l'agent est passé de « J'ai compris le problème » à « voici une PR qui le résout ».
Il y a deux parcours de codage. Pour les changements dans les règles de détection, les listes d'exception, et les suppressions d'alertes, l'agent ouvre des PR vers notre dépôt de détections Panther. C'est le cas le plus classique : une alerte se déclenche régulièrement pour un schéma bénin connu, un ingénieur chargé de la traiter confirme que c'est un faux positif dans le fil Slack, et l'agent génère une entrée dans une liste blanche ou ajuste la règle de détection. Pour tout le reste, comme les changements d'infrastructure, les configurations de services, Terraform ou la configuration des accès basés sur les rôles et les fournisseurs d'identité, l'agent travaille avec notre monorepo.
Dans le cas des PR créées par bot, git blame pointe vers un compte de service, ce qui n'est pas utile pour comprendre le contexte d'une modification des mois ou des années plus tard. Nous incluons désormais le nom de l'ingénieur sécurité demandeur dans la description de la PR et établissons un lien vers le fil de discussion Slack d'origine. Nous aurions dû le faire dès le départ.
Si un réviseur laisse des commentaires sur la PR, l'agent les récupère via un webhook GitHub et peut apporter d'autres modifications ou répondre. Il peut également rebaser des branches obsolètes sur la version master la plus récente lorsque les PR restent ouvertes pendant un certain temps.
Garde-fous
Tous les appels d'outils incluent des sauvegardes déterministes pour s'assurer que l'agent ne tente pas une action non désirée. Par exemple, chaque PR que l'agent crée est automatiquement définie comme brouillon. Ceci est exécuté comme une étape post-déterministe dans le workflow Tines, et non comme une instruction de prompt, car nous avons découvert dès le début que compter sur le LLM pour se souvenir de « toujours créer comme brouillon » n'était pas assez sûr.
Nous utilisons ce type de contrat d'appel d'outil pour mettre en place toutes sortes de contrôles de manière déterministe, pour s'assurer que l'agent ne reçoit ni ne traite d'informations sensibles sur les employés lors de la récupération de données Okta, ou ne tente pas de fermer ou de modifier les demandes d'extraction qu'il n'a pas créées. Parce que la sécurité de tout système repose sur l'application d'une superposition de contrôles, nous portons la plus grande attention à la portée, aux autorisations et à la surveillance des outils disponibles pour l'agent, et à ce que l'agent lui-même travaille pour le compte d'un membre de l'équipe avec les autorisations adéquates.
Nous avons également essayé de contenir les conséquences d'un mauvais contexte. L'agent n'a pas accès en continu à l'ensemble des canaux Slack, et en dehors des messages privés, il ne peut lire un fil de discussion que lorsqu'il a été explicitement re-tagué sur le dernier message.
Enfin, nous avons une bien plus grande confiance dans les fonctions autonomes lorsque les actions sont délimitées, réversibles et soutenues par des preuves claires que lorsqu'elles sont complexes, difficiles à auditer ou impliquent des suppressions. En pratique, cela signifie que les investigations nécessitant la lecture de données volumineuses, la détection des doublons, la récupération des précédents et la correction des brouillons conviennent mieux à une exécution agentique que des actions d'écriture génériques de haute puissance.
Nous anticipons qu'une part plus importante des alertes sera traitée automatiquement au fil du temps, mais seulement avec des garde-fous plus stricts : des périmètres d'action plus étroits, une meilleure évaluation (comme dans cet exemple pour une plus grande confiance dans les agents d'IA via des métriques), et une provenance plus claire des raisons ayant abouti à telle ou telle conclusion.
Quelques réflexions a posteriori
Voici quelques petites choses que nous ferions différemment si nous devions tout recommencer :
- Nous aurions mis en place immédiatement la mémoire procédurale. La mémoire des schémas bâtie par l'agent d'investigation n'a été ajoutée que tardivement, et l'amélioration a été si spectaculaire que tout ce qui l'a précédée semble presque avoir été une perte de temps.
- La configuration en tant que code est essentielle pour éviter la fragmentation de la couche agentique. Les membres d'équipe voulant itérer rapidement, on finit par avoir des personnes créant et exploitant des copies légèrement différentes de l'agent principal avec des configurations d'outils légèrement différentes, utilisées à des fins diverses. Comme vous pouvez l'imaginer, il devient très difficile de s'assurer que tous les outils disponibles pour ces agents sont cohérents et fonctionnent de la même manière. Aujourd'hui, notre ensemble d'outils central est configuré et géré à l'extérieur de tout agent individuel, dans une configuration en tant que code, garantissant que tous les agents peuvent bénéficier d'un ensemble d'actions bien maintenues et standardisées.
- Si vous construisez un agent pour une intégration Slack, le modèle de confiance pour les canaux publics mérite une réflexion en amont. Les contrôles d'autorisation de nos agents garantissent que seuls les membres de l'équipe de sécurité peuvent les commander, mais si un agent décide d'aller fouiller dans les journaux détaillés des activités des utilisateurs, ils pourraient y trouver toutes sortes de données sensibles. La divulgation de données décrivant l'activité d'un utilisateur un certain jour peut être acceptable dans un fil de sécurité privé, mais constituer un énorme problème dans une salle avec cent personnes. Nous traitons ce point grâce à la conception de prompts tenant compte des canaux et d'autres contrôles déterministes, mais il s'agit là d'un aspect auquel vous devez penser dès le départ.
Les étapes actuelles et futures
Le système prend en charge tout le travail initial de réponse aux questions de sécurité pour l'équipe. Le rôle des intervenants humains est passé de « enquêter à partir de zéro » à « examiner ce que l'agent a trouvé, confirmer ou corriger, et traiter les cas qui nécessitent un jugement humain ».
Nous avons constaté une réduction d'environ 70 % du temps de résolution des alertes complexes, une réduction de 20 % des pages de résolution des alertes grâce à la réduction justifiée de la gravité pilotée par l'IA, 25 % de demandes d'approbation de logiciel en moins (l'agent détecte quand un utilisateur pose des questions sur un outil et le dirige vers des alternatives approuvées comparables) et une confiance sensiblement plus élevée des ingénieurs chargés des alertes dans la qualité de la résolution grâce à la chaîne de preuves explicite et vérifiable de l'agent.
Dans un an, le système aura intégré des milliers de décisions de tri, de cartographies de schémas et de corrections de comportements, une volume qu'aucun cerveau humain ne pourrait contenir. C'est ce qui nous rend le plus optimistes : pas une seule intervention agentique particulière, mais le fait que chacune réduit le coût et améliore la précision de la suivante.
Une grande partie de la prochaine phase consiste à construire un meilleur plan de contrôle autour du modèle. Nous voulons des distinctions plus nettes entre nos couches de mémoire (historique et précédents, règles, état). Nous voulons de meilleures façons de décider quand une alerte peut être fermée automatiquement en toute sécurité ou doit être escaladée, même si le modèle semble confiant. Et nous voulons que les workflows en qui nous avons le plus confiance passent d'un comportement de prompts à une automatisation déterministe et inspectable.
Un dernier mot : la pertinence de l'utilisation de l'IA pour enquêter sur des problèmes fait l'objet de nombreuses discussions, car l'IA n'est pas parfaite. Mais les humains ne sont pas parfaits non plus. Nous sommes convaincus qu'il ne s'agit pas de choisir entre les humains et l'IA. Il existe au contraire une infinité de combinaisons pour réduire les risques et améliorer l'efficacité, et elles restent à définir.
Nous recrutons des ingénieurs !
Découvrez les conditions de travail chez Figma et consultez nos postes vacants.
Nous sommes enthousiastes et fiers de ce que nous avons construit, mais nous savons que ce n'est que le début d'un long voyage, riche de promesses mais aussi semé d'embûches. Si d'autres équipes construisent des systèmes similaires, contactez-nous ! Nous adorerions comparer nos observations.